// Fallstudie
Cheetah: ein Projekttool, in dem Agents mitarbeiten dürfen
Für MaKi brauchte ich einen verschachtelten Backlog mit Sprints. Daraus wurde ein Werkzeug, in dem Menschen und Agents dieselbe API, dieselben Regeln und denselben Verlauf teilen.
Ausgangslage
Für die Lernplattform MaKi plane ich Arbeit in vielen Ebenen: Frontend, Backend, Infrastruktur, dazu Lernbausteine mit Themen und einzelnen Übungen. Ein flacher Backlog bildet das nicht ab.
Die Anforderungen:
- Ein Baum statt einer Liste: Items in beliebiger Tiefe, mit Fortschritt pro Ast.
- Sprints quer über den Baum: Eine Aufgabe tief in einem Lernbaustein soll in denselben Sprint wie eine Backend-Aufgabe.
- Mehrere Sichten auf dieselben Daten: Ordner, Kanban, Sprint-Matrix und Boards pro Arbeitsablauf.
Mehrere Werkzeuge kamen in Frage. factro passte beim verschachtelten Backlog am besten, bietet aber keine Sprints. Also habe ich Cheetah gebaut, zuerst nur für Backlog und Sprints.
Später kam eine zweite Anforderung dazu: Viel MaKi-Code entsteht inzwischen mit Claude Code. Den passenden Task suchen, den Status ändern und die Commit-Referenz nachtragen musste ich trotzdem von Hand. Das Werkzeug sollte Agents deshalb als Nutzer kennen, mit denselben Rechten und Grenzen wie Menschen.
Meine Rolle
Cheetah ist ein Nebenprojekt neben der Projektleitung von MaKi, meist abends entstanden. Ich habe es allein entworfen, gebaut und betrieben: alle 455 Commits auf main stammen von mir.
Wie AI beteiligt war: Bis Mitte August 2026 habe ich den Code weitgehend von Hand geschrieben. Seit dem 20. August arbeite ich mit Claude Code. 92 Commits tragen einen Co-Author-Vermerk von Claude, rund 20 % der Historie. In dieser Phase kamen die API mit Tokens, der Verlauf in der Datenbank und der MCP-Server dazu.
Wie ich mit Agents arbeite: Jedes grössere Vorhaben beginnt als Plan in docs/, mit Scope, Nicht-Scope, Datenmodell und offenen Fragen. Umgesetzt wird in nummerierten Stufen, und zu jeder Stufe gibt es ein Prüfskript gegen eine echte Datenbank. Die Pläne halten fest, wo die Umsetzung abgewichen ist und warum. Beispiel: Der MCP-Plan sah 14 Tools vor, gebaut sind 20, weil im Betrieb Bedarf für weitere auftauchte.
Die Begründungen stehen dort, wo man sie braucht: als Kommentare im Datenbankschema, direkt über den Definitionen. Daraus stammen auch die Entscheidungen im Anhang.
Deep Dives
// MCP, Tokens, Akteure
Agents als Nutzer: dieselbe API, dieselben Regeln
Der MCP-Server kennt keine Datenbank. Er ruft dieselbe versionierte API auf wie jede andere Anwendung, mit einem Token, das den Agent identifiziert und begrenzt.
Agent ruft ein Tool auf
- Claude Code Ruft Tools wie list_items oder create_decision auf
- cheetah-mcp Eigenes Package, stdio oder HTTP, kennt keine Datenbank
- /api/v1 Bearer-Token, Scopes, Projektbindung, OpenAPI-Spezifikation
- Domänenlogik Dieselben Regeln wie im Browser, inklusive Schutz gespiegelter Felder
- SurrealDB Trigger schreiben den Verlauf mit «agent:claude-code» als Akteur
Änderung mit Akteur im Verlauf
Tokens pro Akteur. Früher teilten sich alle Integrationen ein Secret, und niemand konnte sagen, wer was geschrieben hatte. Heute hat jede Person und jeder Agent ein eigenes Token: mit Namen (etwa claude-code), Scopes wie items:read oder comments:write, optionaler Bindung an ein einziges Projekt, Ablaufdatum und Widerruf. Gespeichert wird nur der SHA-256-Hash. Der Agent, der für diese Fallstudie Daten aus Cheetah gelesen hat, sah genau ein Projekt und keinen Schreibzugriff darüber hinaus.
Tools, die Buchhaltung abnehmen. 20 Tools decken Lesen, Statuswechsel, Kommentare und das Anlegen von Notizen und Entscheiden ab. Einige sind erst im Betrieb entstanden:
- Idempotente Wiederholung: Ein
externalRefsorgt dafür, dass ein abgebrochener und wiederholter Aufruf kein Duplikat erzeugt. -
list_decisions_since: Eine Antwort in einem Kommentar verändert das Item selbst nicht. Ein Agent, der nur nach geänderten Items fragt, würde neue Diskussionen zu einem Entscheid deshalb übersehen. Das Tool liest den Verlauf statt der Items.
Kein Agent schreibt, was ihm nicht gehört. Gespiegelte Felder (siehe 3.3) sind auch für Agents gesperrt, die API antwortet mit einem klaren Fehler statt einer stillen Änderung.
// Datenmodell in SurrealDB
Ein Baum mit Kanten, und ein Verlauf, den niemand vergessen kann
Der Backlog ist ein Baum, Sprints und Boards sind Kanten. Den Verlauf schreibt die Datenbank selbst, deshalb gilt er für jeden Schreibweg.
Baum und Kanten. Jedes Item hat höchstens ein Eltern-Item, daraus entsteht der Backlog. Alles andere sind Kanten in SurrealDB: Sprint-Zugehörigkeit, Zuweisung und die Position auf einem Board. Das ist bewusst so. Ein Projekt kann mehrere Boards haben, eine Kante auf ein Board ist freiwillig, und die Position in einer Board-Spalte ist eine andere Zahl als die Position im Baum.
Arbeit und Nicht-Arbeit. Sechs Item-Typen teilen sich in zwei Gruppen. Aufgaben, Buckets und Meilensteine haben einen Status und zählen zum Fortschritt. Entscheide und Notizen haben keinen Status und erscheinen weder im Kanban noch im Sprint. Ein Label hätte das nicht leisten können, weil diese Sichten nach Status und Kanten auswählen.
Der Verlauf entsteht in der Datenbank. 20 Trigger (DEFINE EVENT) schreiben Verlauf und Benachrichtigungen. Jede Änderung trägt einen Akteur: user:<name> für Menschen, agent:<name> für Agents, ingest:<quelle> für importierte Daten oder system. Weil die Trigger in der Datenbank laufen, kann weder der Browser noch die API noch ein Import den Eintrag vergessen.
Zwei Abgrenzungen, die ich festgehalten habe:
- Benachrichtigung ist nicht Verlauf. Kurze Signale wie «etwas hat sich geändert, lade neu» werden nach fünf Minuten gelöscht. Der Verlauf dagegen wird nie automatisch gelöscht. Eine Aufbewahrungsfrist wäre ein bewusster Entscheid, kein Nebeneffekt.
- Nicht jede Änderung ist eine Nachricht. Umsortieren per Drag and Drop wird nicht protokolliert, weil niemand «Reihenfolge 4000 → 5000» im Verlauf lesen will.
// Integration mit dem MaKi-Repository
Gespiegelte Items: zwei Systeme ohne Streit um die Wahrheit
Views und Übungen von MaKi leben im Repository. Cheetah spiegelt sie, besitzt aber nur die Planungsfelder und schreibt nie zurück.
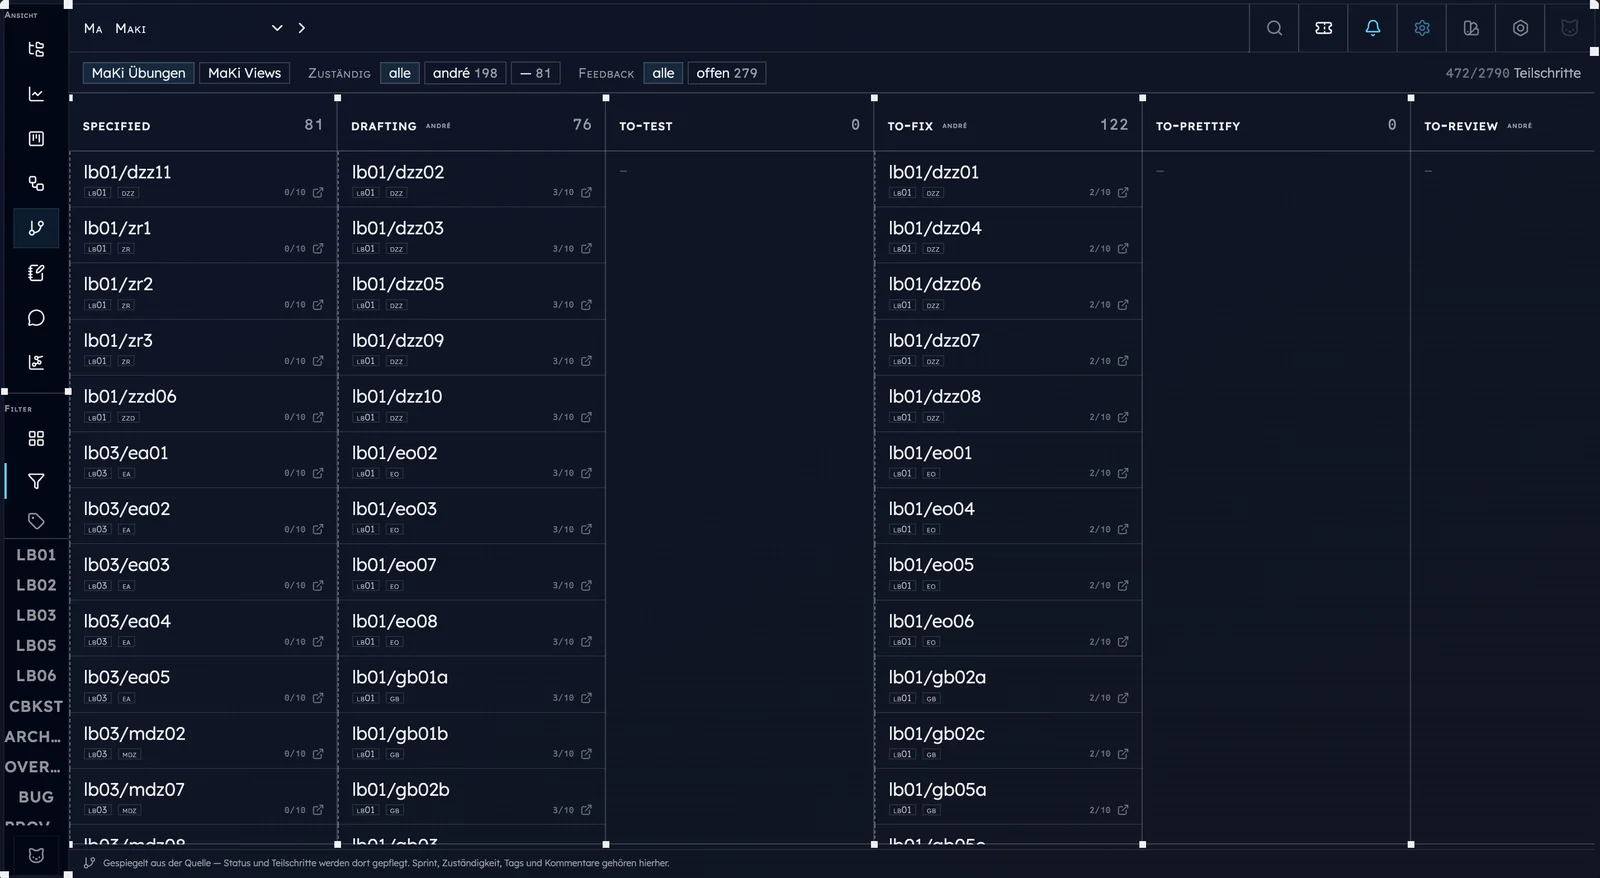
Das Problem. Welche Views und Übungen von MaKi fertig sind, weiss das Repository am besten: Dort sind sie definiert, pro Branch versioniert und von der CI geprüft. Geplant wird aber in Cheetah. Eine Karte von Hand nachzuführen, hätte zwei Wahrheiten erzeugt.
Die Lösung: Besitz pro Feld, nicht pro Datensatz. Ein Skript liest die Dokumentation im MaKi-Repository und schickt die Karten an einen Import-Endpunkt. Titel und Status gehören dem Repository. Den Status des Repositorys speichert Cheetah wörtlich in einem eigenen Feld, weil das eigene Status-Schema ihn nicht verlustfrei abbilden kann. Sprint, Zuweisung, Kommentare, Tags und Termine gehören Cheetah und bleiben bearbeitbar.
- Der Import ist idempotent: Bestehende Karten werden aktualisiert, nie doppelt angelegt.
- Verschwundene Karten werden gemeldet, nicht gelöscht. Ein Fehler im Export soll keine Planung vernichten.
- Ein Projekt abonniert eine Quelle ausdrücklich, statt dass eine Projekt-ID im Code steht.
Commits und Pull Requests. Ein GitHub-Webhook, geprüft per HMAC-Signatur, ordnet Commits und Pull Requests deterministisch den passenden Items zu und hält sie als Kommentar fest. Jede Zustellung wird einmal verarbeitet, auch wenn GitHub sie wiederholt. Ein LLM als Rückfallebene für unklare Fälle ist geplant, aber nicht gebaut.
Stand & Ausblick
Heute: Ich plane die Sprints von MaKi in Cheetah, und die Views und Übungen aus dem Repository sind gespiegelt. Das Team nutzt das Werkzeug bisher kaum. Der MCP-Server ist seit September in Betrieb und wird erst gelegentlich genutzt.
Qualität: Die CI prüft bei jedem Push Typen und rund 135 Unit-Tests, die letzten 16 Läufe waren grün. Die Dokumentation zu Datenbankschema, Routen und Roadmap wird aus dem Code erzeugt, ein Pre-commit-Hook und die CI brechen ab, wenn sie veraltet ist. Ehrlich dazu: Es gibt nur vier End-to-End-Tests, und sie laufen nicht in der CI.
Ziele für die nächsten Wochen:
- Das Team an Bord holen. Ich brauche mehr Überblick, wer woran arbeitet. Rollen, Rechte und Zuweisungen dafür sind gebaut.
- Vorher härten. Registrierung und Sessions sind für einen einzelnen Nutzer ausgelegt und müssen vor dem Einsatz im Team strenger werden.
- Über Sprints hinaus planen: Cheetah soll auch Business Case und Projektphasen abbilden. Eine Gantt-Ansicht dafür ist als Entwurf auf einem Branch vorhanden.
- AI-Funktionen im Werkzeug selbst sind geplant, aber nicht gebaut: Sprint-Zusammenfassungen, Hinweise auf mögliche Duplikate, Digests. Heute kommt AI nur über externe Agents ins Spiel.
Lessons Learned
Was ich in ein Team mitbringe
- Schnittstellen für Agents entwerfen: Identität pro Agent, Scopes, Projektbindung, Idempotenz und ein Verlauf mit Akteur, sodass nachvollziehbar bleibt, was ein Agent getan hat.
- Datenmodelle, die Regeln erzwingen: Invarianten in der Datenbank statt in jedem Schreibweg, und klare Besitzverhältnisse, wenn zwei Systeme dieselben Daten kennen.
- Pragmatische Entscheide mit schriftlicher Begründung: was gebaut wird, was geparkt wird und unter welcher Bedingung es zurückkommt.