// Fallstudie
Architektur einer adaptiven KI-Lernplattform
Von probabilistischer Lernstandanalyse (BKT) zu Empfehlungen in unter einer Millisekunde, für ein Mathematik-Lehrmittel.
Ausgangslage
Das Projekt begann als Proof of Concept für einen LLM-basierten Mathematik-Tutor. Nach Feldtests mit Schulklassen fiel der Entscheid, daraus ein vollständiges Lehrmittel zu entwickeln: gedruckte Hefte und eine Lernplattform, die sich an jedes Kind anpasst.
Für wen:
- Lernende der Primarschule sollen Aufgaben erhalten, die zu ihrem Stand passen, und Unterstützung durch einen KI-Tutor.
- Lehrpersonen sollen verständlich sehen, wo ihre Klasse und jedes Kind steht, und den Unterricht danach planen.
- Das Didaktik-Team entwickelt die Aufgaben und testet sie laufend auf der Plattform.
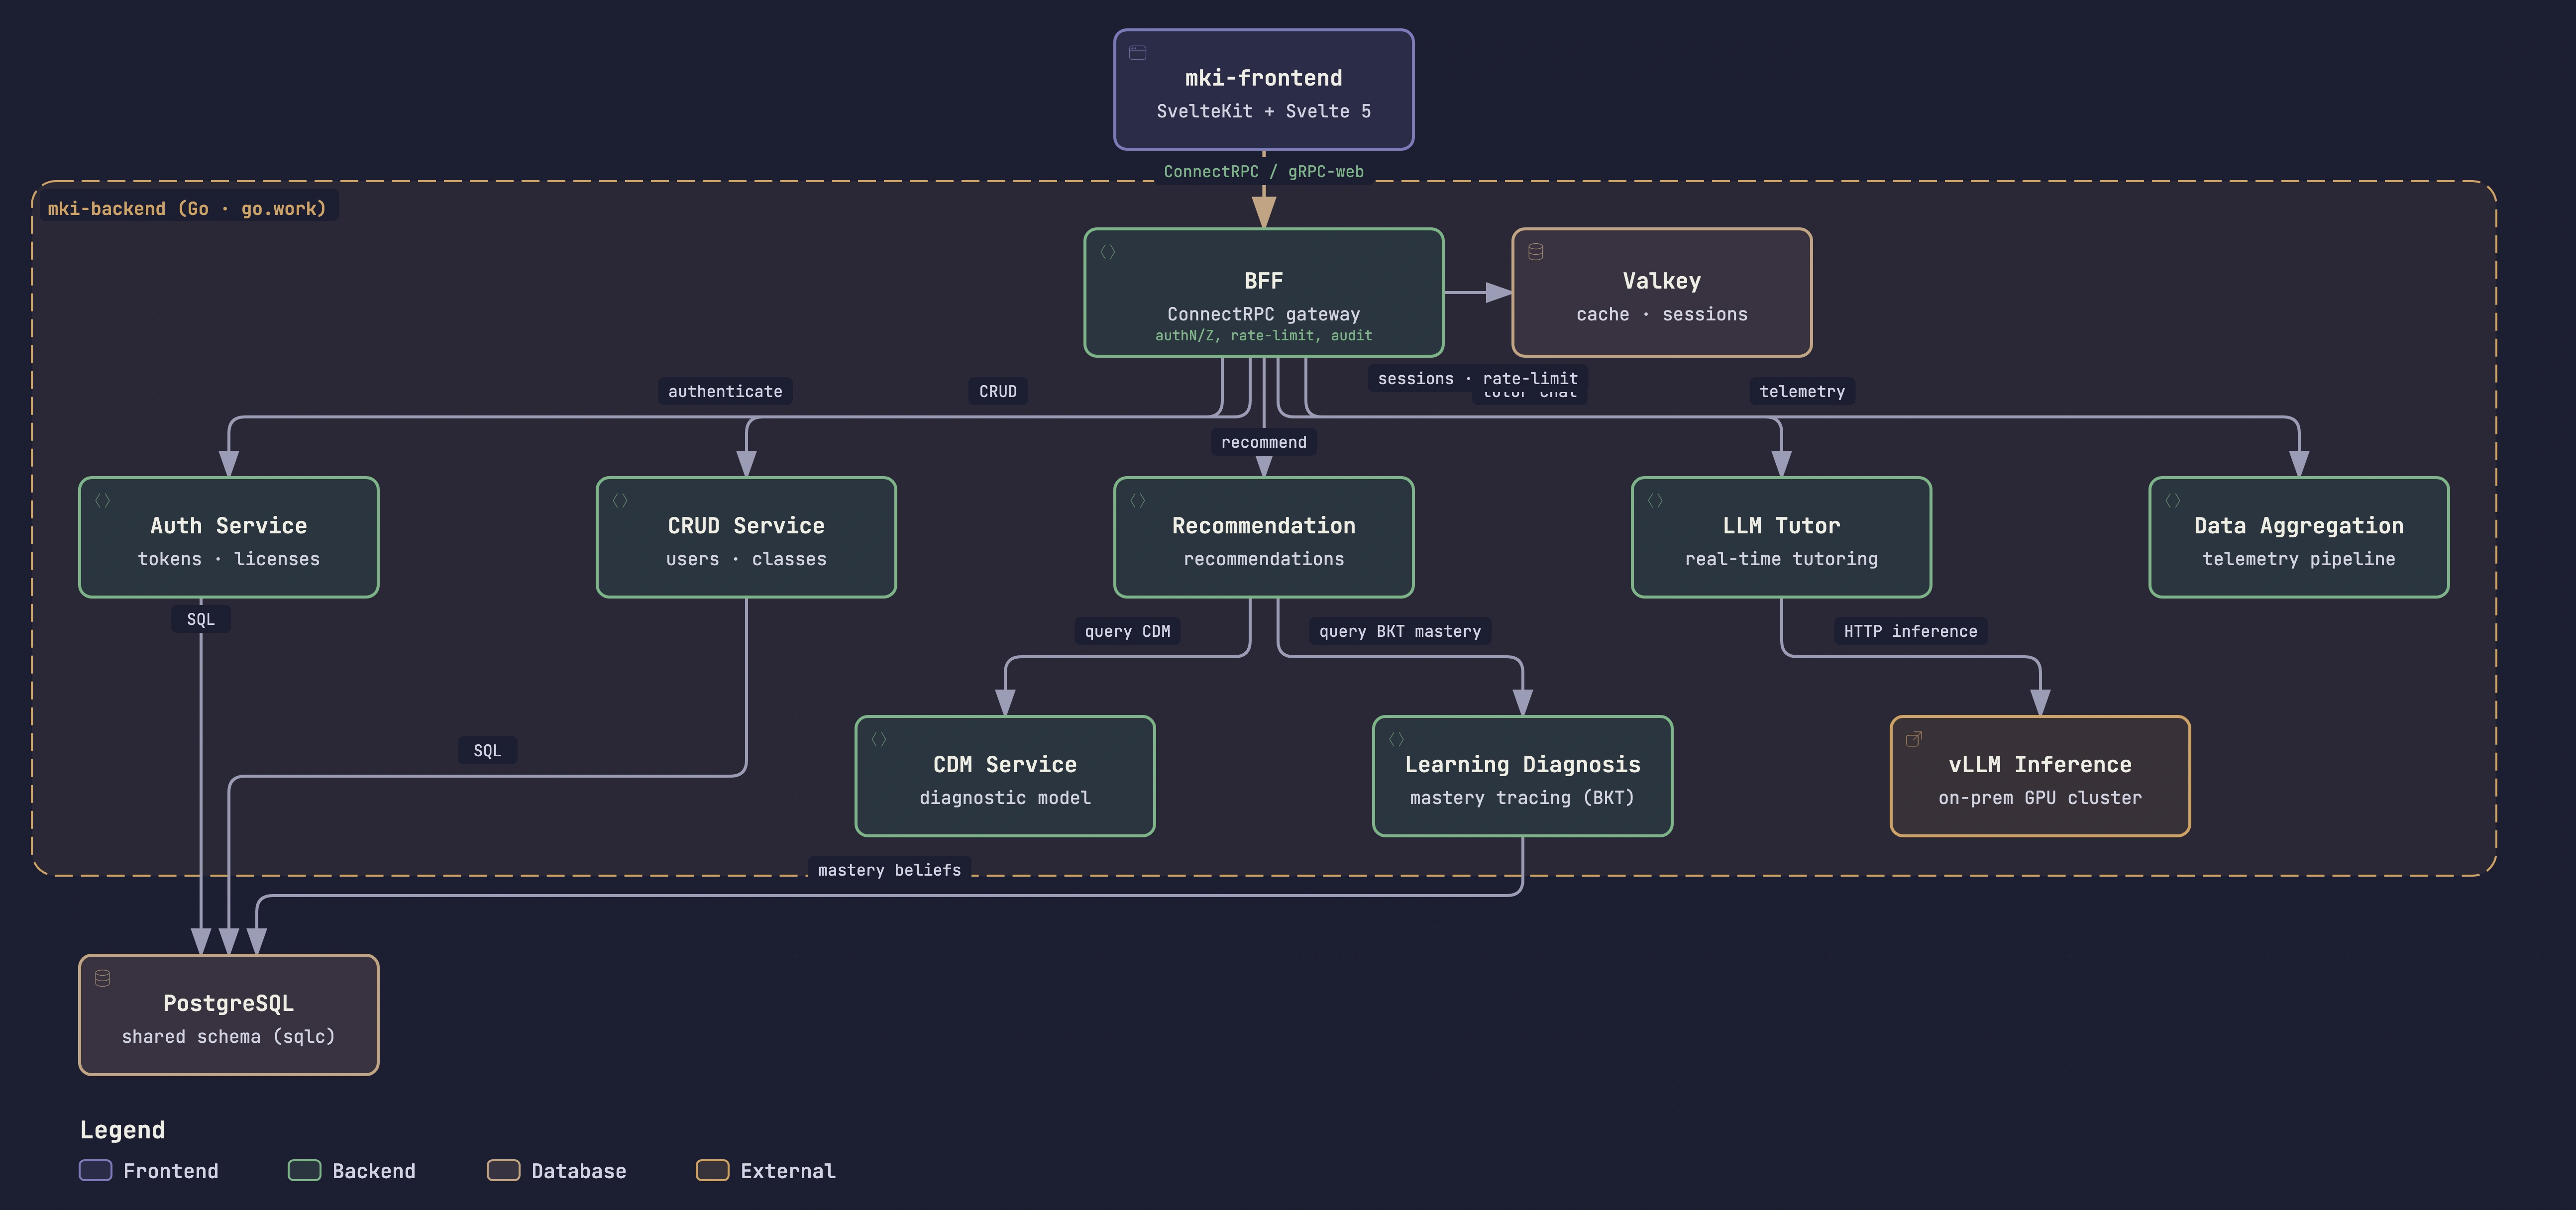
Die Rahmenbedingungen: Ein kleines Team, ein fester Rahmen, Daten von Minderjährigen und die Vorgabe, auf Kubernetes mit Microservices zu bauen. Ich habe diese Vorgabe pragmatisch umgesetzt: Einfache CRUD-Logik läuft konsolidiert, spezialisierte KI- und Analysedienste bleiben eigenständig.
Meine Rolle
Als Gesamtprojektleiter verantworte ich das ganze Lehrmittel, von der Planung über die Zusammenarbeit mit Fachdidaktik, Autorenteam und Design bis zur Technik. Die Technik setze ich grösstenteils selbst um:
- Systemarchitektur: Grenzen zwischen den Services, Datenhaltung, Kommunikation und Betrieb. Als der Kubernetes-Testcluster längere Zeit ausfiel, lief das Frontend auf einem separaten Server weiter, damit das Didaktik-Team ohne Unterbruch Aufgaben testen konnte.
- Backend & AI Engineering: Alle Go-Services inklusive Authentifizierung, Datenbankdesign, Lernstandanalyse, Empfehlung und Anbindung selbst gehosteter Sprachmodelle.
- Datenschutz & Security: Das Informationssicherheits- und Datenschutzkonzept für eine Plattform, die Daten von Minderjährigen verarbeitet.
- Frontend & UX: Die Architektur des SvelteKit-Frontends trennt die Logik jeder Aufgabe von ihrer Darstellung. Ich schreibe die Logik, die Views und funktionale Visualisierungen und entscheide die Interaktion, etwa welche Zahlen als verschiebbare Karten erscheinen. Zusammen mit einer Junior-Entwicklerin haben wir im Juni und Juli 2026 145 interaktive Aufgaben realisiert.
- Team: Die Junior-Entwicklerin testet die Aufgaben und gestaltet sie visuell aus. Das ist bewusst nur 70 % ihrer Arbeit: 20 % entwickelt sie interne Tools, 10 % ein eigenes Projekt, jeweils mit eigener Verantwortung für den Code. Dort arbeite ich mit ihr an Architekturfragen, mit dem Ziel, dass sie nach unserer Zusammenarbeit keine Junior mehr ist.
- Kompetenzmodellierung: Kompetenzkarten (CbKST) als Brücke zwischen Didaktik und Algorithmus.
Didaktik in Modelle übersetzen: Das Didaktik-Team beschreibt Aufgaben in seiner eigenen Sprache: Lernziel, Werkzeug wie die Stellenwerttafel, typische Schwierigkeiten. Mit Wissensräumen arbeitet es nicht, die Kompetenzmodellierung liegt deshalb ganz bei mir. Ich übersetze die Beschreibungen in Kompetenzkarten: Welche Fähigkeit baut auf welcher auf, welche Aufgabe prüft welche Fähigkeit, und wo steht das im Lehrplan 21? Eine Aufgabe zur Multiplikation mit Zehnerpotenzen etwa prüft neben dieser Fähigkeit auch das Stellenwertverständnis.
Dafür habe ich ein LLM-Wiki aufgebaut: Ein KI-Agent verdichtet Lehrplan und Fachliteratur zu 364 atomaren Kompetenzen und setzt daraus 40 Themenkarten zusammen. Jede Aussage trägt ihre Quelle, die didaktischen Entscheide treffe ich. Ein automatischer Check verhindert, dass ein Entwurf behauptet, von Fachpersonen geprüft zu sein. Auch die Zuordnung der Aufgaben zu Kompetenzen leitet ein Agent aus der Aufgabendokumentation ab, jede Zeile mit Belegstelle, bevor ich sie bestätige.
Deep Dives
stellenweise
Löse die Termkarten
schrittweise
Löse die Termkarten
// Algorithmen & Performance
Empfehlung aus 13 Faktoren
Die nächste passende Aufgabe in Echtzeit: 13 Faktoren, drei Schwierigkeitskörbe und p99 unter 0,5 ms.
Der recommendation-service schlägt zu einem Thema, oder themenübergreifend als Repetition, immer drei nach Schwierigkeit gestaffelte Aufgaben vor. Die Lernenden wählen selbst. Das stärkt die Selbstwirksamkeit, und die Wahl ist ihrerseits ein Signal für das System.
1. Drei Körbe und Explainability
Jede Aufgabe erhält einen erwarteten Ausgang auf einer Skala von 0 bis 5 und landet in einem von drei Körben:
- Challenge: anspruchsvoll, um gezielt eine Hürde zu nehmen.
- Goldilocks: die optimale Lernzone, Erfolg mit wenig Unterstützung.
- Easier: Repetition oder Aufbau von Selbstvertrauen.
Gemessen wird der Ausgang aus dem Verhalten, ohne die Kinder zu befragen: von 0 (falsch nach mehreren Versuchen) über 2 (richtig mit Hilfe des Tutors) bis 5 (richtig und schnell). Leere Körbe füllt die nächstgelegene Aufgabe (closest-fallback). Die Grenzen verschieben sich mit den Entscheidungen der Lernenden, und die Übergänge zwischen Wissensstand und Aufgabe werden laufend nachgelernt. Nach jeder Aufgabe wird der vorhergesagte mit dem tatsächlichen Ausgang protokolliert. Jede Empfehlung liefert zudem einen Explainability-Trace, der zeigt, welcher Faktor wie viel beigetragen hat.
confidence-boosterNach drei Fehlversuchen: Erfolgserlebnis + Bonusband-activationLiegt mitten im Korb „Easier“ + BonusexplorationSelten erprobte Kombination + Bonuscbkst-fringeSchon gemeistert, nichts Neues − Abzug
Echter Trace aus der Engine, mit synthetischen Testdaten: Ein Kind ist dreimal hintereinander gescheitert. Im Korb „Easier“ bietet die Engine eine bereits gemeisterte Aufgabe an, damit ein Erfolgserlebnis folgt. Jeder Balken zeigt, wie stark ein Faktor die Empfehlung gestützt oder gebremst hat.
2. Die 13 Faktoren
Jede Kandidaten-Aufgabe durchläuft nacheinander 13 Faktoren. Frühe Faktoren setzen die pädagogische Priorität, spätere korrigieren gegen Langeweile, Vergessen und Filterblasen. Die Gewichte sind konfigurierbar, damit sie sich nach dem Go-Live mit echten Daten kalibrieren lassen.
3. Performance
Die Empfehlung soll sich für Lernende sofort anfühlen. Gemessen habe ich den kompletten Empfehlungs-Use-Case mit 100 Kandidaten-Aufgaben, die Aufrufe anderer Services gemockt:
- p50 rund 0,16 ms, p99 unter 0,5 ms.
- Rund 5’500 Empfehlungen pro Sekunde auf einem einzelnen CPU-Kern.
Deshalb rechnet die Engine im Moment der Anfrage, statt mögliche Lernwege auf Vorrat zu berechnen und zu cachen. Das spart Infrastruktur, ohne dass jemand eine Wartezeit spürt.
Gemessen lokal auf einem Apple M1 (16 GB), ohne Netzwerk. Messungen im Cluster stehen noch aus, weil die Zielumgebung noch nicht live ist.
// Didaktisches Domänenmodell
Probabilistische Lernstandanalyse (BKT & CbKST)
Laufende Schätzung des Wissensstands mit Bayesian Knowledge Tracing und Wissensraumtheorie, fair und nachvollziehbar.
Der learning-diagnosis-service beantwortet zwei Fragen: Was ist gemeistert, und was ist als Nächstes lernbar? und Wie sicher ist diese Einschätzung, wenn man Vergessen und bisherige Ergebnisse berücksichtigt?
1. CbKST & Bayesian Knowledge Tracing
Der Dienst kombiniert zwei etablierte Modelle der Kognitionswissenschaft:
- Wissensräume (CbKST) mit DNF-Voraussetzungen: Abhängigkeiten zwischen Kompetenzen sind als disjunktive Normalform modelliert. Statt aller Kombinationen rechnet das System nur mit den tatsächlich möglichen Wissenszuständen.
- Zwei Schätzverfahren: exakte Bayes-Inferenz über alle möglichen Zustände, solange ihre Zahl überschaubar bleibt, sonst ein speichersparender Schätzer pro Kompetenz.
- Bayesian Knowledge Tracing mit Hysterese: Updates über sechs Evidenzstufen, von wiederholtem Scheitern bis zu schnellem Erfolg. Eine Kompetenz gilt ab als gemeistert und erst unter wieder als offen. Das verhindert, dass die Anzeige bei jeder Antwort hin und her springt.
- Parameter aus Daten: Die BKT-Parameter werden per EM-Verfahren geschätzt, mit Schutz vor degenerierten Lösungen.
2. Vergessen, Nachteilsausgleich und Nachvollziehbarkeit
- Vergessen: Wahrscheinlichkeiten zerfallen exponentiell über eine Halbwertszeit. Berechnet wird beim Lesen statt in nächtlichen Batch-Jobs. Wird eine Voraussetzung vergessen, wirkt das auf die Kompetenzen, die darauf aufbauen. Umgekehrt frischt jede bearbeitete Aufgabe die Grundlagen auf, die sie voraussetzt. So fragt das System nur wirklich Vergessenes erneut ab.
- Nachteilsausgleich: Für Lernende mit Nachteilsausgleich oder Sprachbarrieren zählt ein schneller Erfolg gleich wie ein langsamer. Die Reaktionszeit benachteiligt so niemanden systematisch.
- Nachvollziehbarkeit: Jede Änderung wird mit Vorher- und Nachher-Wert gespeichert. Lehrpersonen und Prüfstellen sehen, warum das System eine Kompetenz als gemeistert einstuft. Der ganze Zustand lässt sich aus dem Beobachtungsprotokoll neu aufbauen.
3. Performance und Konsistenz
- Bitmasken statt Objektgraphen: Wissenszustände sind als Bitmasken gespeichert, Bayes-Updates laufen als Bit-Operationen. Bei kettenförmigen Themen mit 20 bis 50 Kompetenzen dauert ein Update 0,02 bis 0,2 ms, bei stark verzweigten Themen einige Millisekunden.
- Transactional Outbox: Neu gemeisterte Kompetenzen werden in derselben PostgreSQL-Transaktion wie das Update in eine Outbox geschrieben. Das ist konsistent ohne verteilte Transaktionen.
- Robuste Erfassung: Ergebnisse werden atomar im Batch gespeichert, mit Idempotency-Keys und optimistischem Locking.
// Security & Supply Chain
Security und Datenschutz als Architektur
Authentifizierung, Autorisierung, Audit und Überlastschutz als feste Interceptor-Ketten, Zero Trust zwischen den Services und signierte Images.
1. Interceptor-Ketten und Zero Trust
Jeder Aufruf passiert je nach Service eine von drei festen Interceptor-Ketten. Die Geschäftslogik enthält keinen Security-Code:
- Edge (BFF): Prüft Login-Token kryptografisch, begrenzt Anfragen pro Nutzer, protokolliert Zugriffe auf Personendaten und validiert jede Eingabe gegen das Protobuf-Schema.
- Interne Services: Vertrauen keinem Klartext-Header. Die Identität kommt als kurzlebiges, vom BFF signiertes Token und wird in jedem Service unabhängig geprüft. Die Autorisierung entscheidet Cerbos pro Endpunkt.
- KI-Services: Zusätzlich eine adaptive Nebenläufigkeitsgrenze, die sich an der gemessenen Latenz orientiert und den Dienst vor Überlast schützt.
Datensparsamkeit: Die Empfehlung kennt weder Namen noch Geschlecht oder Klasse eines Kindes, nur ein Pseudonym und den Lernstand.
Dazu kommen mTLS zwischen allen Services (Linkerd), Network Policies, die interne Dienste nur für das BFF erreichbar machen, und ein PII-Scrubber, der Personendaten aus Telemetrie und Logs entfernt, bevor etwas gespeichert wird.
2. Signierte Artefakte statt Vertrauen
- Build ohne Dockerfile: Die Go-Services baut ko, das SvelteKit-Frontend Pokkum, mein eigener Container-Compiler für SvelteKit. Beide erzeugen Distroless-Images, die als Non-Root laufen.
- Prüfen: GoSec, govulncheck, OSV-Scanner und Trivy laufen bei jedem Build.
- Signieren: Cosign signiert jedes Image keyless über die OIDC-Identität von GitHub Actions. Es gibt keinen langlebigen Signing-Key, der verloren gehen kann.
- Ausrollen: ArgoCD synchronisiert drei Umgebungen aus einem GitOps-Repository.
Ehrlicher Stand: Build, Scans und Signierung laufen in der CI. Die Kyverno-Policy, die unsignierte Images im Cluster abweist, die automatische Promotion ins GitOps-Repository und die Nuclei-Scans nach dem Deployment sind vorbereitet, aber noch nicht live, weil die Zielumgebung noch nicht betrieben wird.
Git Push
- Build ko (Backend), Pokkum (Frontend), Distroless, Non-Root
- Scan GoSec, govulncheck, OSV-Scanner, Trivy
- Sign Cosign keyless (GitHub OIDC)
- Promote GitOps + ArgoCD (vorbereitet)
- Enforce & Test Kyverno, Nuclei (vorbereitet)
Cluster
Stand & Ausblick
Die Plattform ist in Entwicklung: 198 von 279 geplanten Aufgaben sind umgesetzt, das Lehrmittel ist für Sommer 2027 geplant. Algorithmen und Gewichte werden erst mit echten Lerndaten feinjustiert. Belastbare Aussagen zur Wirkung auf den Lernerfolg kann ich deshalb heute noch nicht machen.
Das Ziel ist klar: Lernende erhalten Aufgaben, die zu ihrem Stand passen, und Lehrpersonen einen verständlichen Einblick in die Fähigkeiten ihrer Klasse, damit sie den Unterricht gezielter planen können.
Lessons Learned
Was ich in ein Team mitbringe
- Projektleitung und Umsetzung aus einer Hand: Ich kenne Planung, Stakeholder und Termine genauso wie den Code. Entscheide treffe ich mit Blick auf beides.
- Eine Brücke zwischen Fachwelt und Technik: Fachliche Konzepte in überprüfbare Modelle übersetzen, ohne dass die Fachpersonen ihre Sprache aufgeben müssen.
- Architektur mit Augenmass: Lösungen, die ein kleines Team betreiben kann, und die Bereitschaft, eigene Entscheide zu revidieren.
- Security und Datenschutz von Anfang an: belegt durch Tests statt Annahmen.
- KI als Hebel mit Leitplanken: ein erprobter Weg, mit Agents ein Vielfaches zu leisten, ohne die Kontrolle über die Qualität abzugeben.